Étude de cas
Rien de perdu : une messagerie de trading opérée comme une équipe SRE
Des traders échangent en temps réel, et la loi impose d’archiver chaque message. Le système fait donc deux promesses : rapide, et rien de perdu. J’en ai construit une miniature sur Kubernetes, puis j’ai passé autant de temps à essayer de la casser.

- Latence p99
- 11 ms
- SLO : < 200 ms
- Détection
- 161 s
- mauvaise release
- Rétablissement
- 79 s
- un rollback
- Messages perdus
- 0
- sur chaque scénario
Construire : rapide, et rien de perdu
- Un message est écrit dans un journal durable (un Redis Stream sur un volume persistant) avant que le trader reçoive « 202 Accepted ».
- Trois réplicas de l’API, répartis sur deux nœuds, le poussent à chaque trader connecté en WebSocket.
- Un archiveur lit le même journal et n’acquitte un message qu’après l’avoir écrit sur disque : un crash peut dupliquer, jamais perdre.
Le livrer : chaque commit est déployé avant d’être accepté
Le pipeline ne se contente pas de compiler : il déploie le commit sur un cluster Kubernetes jetable, simule 20 traders, et refuse la release si le SLO n’est pas tenu ou si un seul message n’est pas archivé.
- Secrets
- Tests
- Build
- Scan CVE
- Déploiement + charge
- Verdict SLO
En production, Argo CD aligne le cluster sur Git : une modification manuelle est annulée en moins de 5 s, et un rollback devient un « git revert » relu et tracé.
Le casser exprès
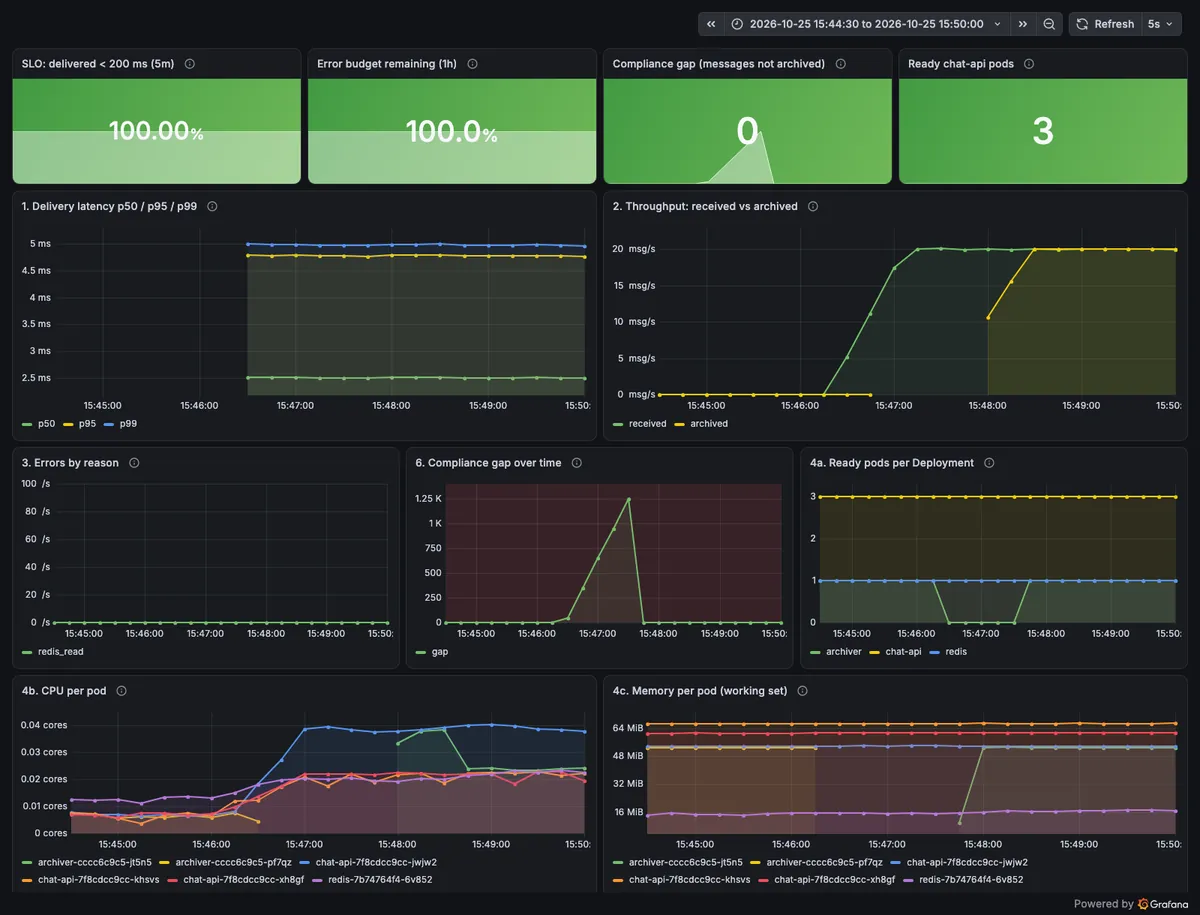
- Tuer un pod de l’API sous charge Le trafic le contourne 0 erreur · 2 399 / 2 399 archivés
- Arrêter l’archiveur Alerte critique, puis rattrapage 1 249 messages rattrapés en < 15 s
- Livrer une release 300 ms plus lente Alerte, rollback en une commande 161 s pour détecter · 79 s pour rétablir
- Livrer une release qui manque de mémoire Le déploiement se bloque tout seul aucun impact utilisateur
- Demander à un assistant IA si tout va bien Il lit alertes et runbooks, sans rien modifier chaque appel journalisé
Ce que le casser m’a appris
Sept vrais problèmes, invisibles pour une suite de tests verte :
- Un redémarrage de Redis laissait une connexion morte : reconnexion et nouvel essai.
- L’indicateur de conformité criait au loup à chaque redémarrage : mesurer à la source.
- Une mise à jour annulait en silence une correction manuelle : tant que ce n’est pas dans Git, ce n’est pas fait.
- Une alerte sonnait encore 5 minutes après la correction : fenêtre réduite.
- Les mises à jour coupaient des requêtes : un délai avant l’arrêt, et 0 erreur.
- Le monitoring tombait pendant l’incident qu’il montrait : dimensionné sur l’observé.
- Une clé privée s’est glissée dans un commit : interceptée avant le push, puis détectée automatiquement en pre-commit et en CI.
Construit avec un assistant de code IA (Claude Code), en vérifiant chaque décision par l’exécution : chaque chiffre de cette page a été mesuré, pas estimé.